



Robots IA (GPTBot, ClaudeBot, PerplexityBot) : guide technique pour votre robots.txt
En résumé : une étude portant sur 10 894 domaines (juillet 2026) a mesuré que 39,5 % des sites qui bloquent GPTBot dans leur robots.txt le laissent quand même passer dans les faits. Le fichier robots.txt déclare une intention ; c’est votre CDN ou votre pare-feu qui l’applique, ou pas. Ce guide explique comment identifier les principaux robots IA, configurer un robots.txt qui fonctionne réellement, et comprendre ce qu’un blocage change (et ne change pas) pour votre visibilité dans les IA génératives.
Un client a déjà bloqué ChatGPT dans son robots.txt en pensant avoir réglé la question, pour découvrir six mois plus tard que ses pages continuaient d’être citées dans les réponses de ChatGPT. Ce n’est pas un bug : c’est le fonctionnement normal du système. Le robots.txt est une déclaration d’intention, pas une serrure. Ce qui bloque réellement un robot, c’est votre serveur, votre CDN ou votre pare-feu applicatif — et la majorité des sites n’ont configuré aucun des deux correctement.
Pour une agence web à Bromont qui accompagne des PME en SEO technique et en GEO, la gestion des robots IA est devenue une question récurrente en 2026. Ce guide couvre les robots à connaître, la différence entre entraînement et recherche en temps réel, et ce que les données réelles d’application montrent — pas seulement ce que les blogs de vulgarisation répètent.
Pourquoi la gestion des robots IA est devenue stratégique
Chaque grand modèle de langage dépend d’un robot d’indexation pour lire le contenu du web, que ce soit pour l’entraînement, pour répondre en temps réel à une question d’utilisateur, ou pour alimenter un moteur de recherche conversationnel. Ces robots se comportent différemment des robots de recherche classiques : ils ne respectent pas toujours le robots.txt, certains changent d’identité pour contourner les blocages, et la distinction entre « robot d’entraînement » et « robot de citation en temps réel » change complètement le calcul stratégique.
Bloquer aveuglément tous les robots IA peut couper une PME des citations dans ChatGPT ou Perplexity — des canaux qui apportent déjà du trafic qualifié à certains sites. Ne rien bloquer laisse le contenu du site alimenter l’entraînement de modèles concurrents sans contrepartie. La bonne approche est sélective, pas binaire.
Les principaux robots IA à connaître
| Robot | Entreprise | Fonction |
|---|---|---|
| GPTBot | OpenAI | Collecte de contenu pour l’entraînement des modèles |
| OAI-SearchBot | OpenAI | Indexation continue pour ChatGPT Search |
| ChatGPT-User | OpenAI | Requêtes déclenchées par un utilisateur dans ChatGPT |
| ClaudeBot | Anthropic | Collecte de contenu pour l’entraînement de Claude |
| Claude-SearchBot | Anthropic | Améliore la pertinence des résultats de recherche de Claude |
| Claude-User | Anthropic | Requêtes déclenchées par un utilisateur dans Claude |
| PerplexityBot | Perplexity | Indexation pour les résultats de recherche Perplexity |
| Google-Extended | Contrôle l’usage du contenu pour Gemini et AI Overviews | |
| CCBot | Common Crawl | Archive publique utilisée en amont par de nombreux modèles |
Anthropic a formalisé cette architecture à trois robots en 2026 : ClaudeBot pour l’entraînement, Claude-SearchBot pour la qualité des résultats de recherche, et Claude-User pour les requêtes déclenchées directement par un utilisateur dans Claude. Chacun peut être autorisé ou bloqué indépendamment dans le robots.txt — bloquer ClaudeBot n’empêche pas Claude-User de continuer à visiter une page qu’un utilisateur demande explicitement. Source : Search Engine Roundtable, 2026.
Entraînement vs recherche en temps réel : la distinction qui change tout
La plupart des fournisseurs séparent maintenant deux familles de robots : ceux qui collectent du contenu pour entraîner un futur modèle, et ceux qui consultent le web en temps réel pour répondre à une question posée maintenant. Bloquer les premiers sans bloquer les seconds permet de refuser que votre contenu serve à l’entraînement, tout en restant éligible à une citation dans une réponse générée.
Concrètement, un site peut choisir de bloquer GPTBot et ClaudeBot (entraînement) tout en autorisant OAI-SearchBot, ChatGPT-User, Claude-SearchBot, Claude-User et PerplexityBot (recherche et citation) :
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: Claude-User
Allow: /

User-agent: PerplexityBot
Allow: /
Cette configuration place le curseur sur « nous refusons l’entraînement, nous acceptons la citation » — un compromis raisonnable pour une PME qui veut protéger son contenu original sans disparaître des réponses IA.
Ce qu’un blocage robots.txt fait réellement (et ce qu’il ne garantit pas)
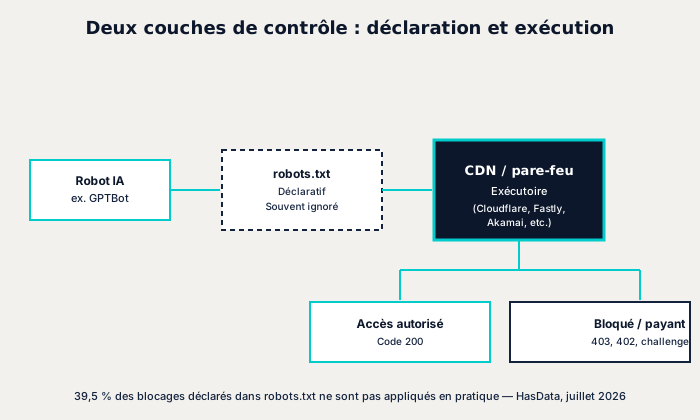
Le robots.txt est un fichier texte que les robots bien élevés consultent avant de crawler un site — un standard formalisé sous RFC 9309, mais qui reste une demande volontaire, sans force d’exécution propre. Le blocage réel se produit à une autre couche : votre serveur, votre CDN (Cloudflare, Fastly, Akamai) ou votre pare-feu applicatif, qui doit explicitement filtrer les requêtes par en-tête User-Agent ou par plage d’adresses IP.
Deux robots peuvent annoncer le même User-Agent avec un comportement complètement différent : l’un respecte scrupuleusement le robots.txt, l’autre l’ignore. C’est pourquoi une déclaration dans le robots.txt sans application technique correspondante au niveau du serveur ne bloque rien du tout dans les faits.
Ce qu’une étude sur 10 894 domaines révèle sur l’application réelle
Une étude publiée par HasData en juillet 2026, portant sur 10 894 domaines (le top 10 000 Tranco plus 1 148 sites d’actualités), a mesuré l’écart entre ce que les sites déclarent dans leur robots.txt et ce qui se passe réellement lorsqu’un robot IA se présente.
Premier constat : les éditeurs de contenu bloquent les robots IA environ cinq fois plus que le web dans son ensemble. Le taux de blocage de GPTBot atteint 50,5 % chez les éditeurs de presse, contre seulement 7,9 % sur l’ensemble du top 10 000 sites. Mais parmi les 592 sites qui déclarent bloquer GPTBot dans leur robots.txt, 39,5 % le laissent quand même passer avec un code 200 lors d’une requête réelle — ce que l’étude appelle un « blocage sur papier ». Source : HasData, juillet 2026.
Deuxième constat, tiré d’un test comparant l’accès de cinq robots à 250 sites d’éditeurs depuis une adresse IP résidentielle : ClaudeBot reçoit le traitement le plus sévère, avec un taux d’accès de seulement 36,8 %, contre 77,2 % pour un navigateur standard depuis la même adresse — un écart de 40 points. PerplexityBot s’en tire un peu mieux, à 45,2 % (32 points d’écart), et GPTBot à 44,4 % (33 points d’écart). L’étude avance une explication plausible : OpenAI a signé des ententes de licence avec plusieurs éditeurs avant Anthropic, ce qui adoucirait le traitement réservé à GPTBot par rapport à ClaudeBot, qui n’a ni la couverture d’une entente commerciale ni l’image d’un assistant de recherche grand public comme Perplexity.
| Robot | Taux d’accès réel | Écart vs navigateur |
|---|---|---|
| Navigateur standard | 77,2 % | Référence |
| PerplexityBot | 45,2 % | -32 points |
| GPTBot | 44,4 % | -33 points |
| ClaudeBot | 36,8 % | -40 points |
Troisième constat, plus contre-intuitif : changer d’adresse IP ne sert presque à rien pour un robot qui veut contourner un blocage. Seulement 3,5 % des domaines qui bloquaient GPTBot depuis une IP de centre de données l’ont laissé passer depuis une IP résidentielle. L’application se fait presque exclusivement sur la chaîne du User-Agent, pas sur la plage d’adresses IP.
Le cas Perplexity : quand un robot ignore le blocage
En août 2025, Cloudflare a publiquement accusé Perplexity de pratiquer le « crawling furtif » : lorsque son robot se heurtait à un blocage, il aurait changé sa chaîne User-Agent pour imiter un navigateur Chrome standard, fait tourner des adresses IP absentes de son propre registre de robots, et modifié son numéro de système autonome (ASN) pour contourner les règles de pare-feu. Cloudflare a retiré Perplexity de son programme de robots vérifiés à la suite de cette découverte. Perplexity a contesté fermement les conclusions de Cloudflare, qualifiant l’analyse d’erronée. Source : Winbuzzer, août 2025.
Cet épisode, toujours contesté par les deux parties, illustre concrètement pourquoi un blocage déclaré dans un robots.txt seul est insuffisant : si un robot est disposé à masquer son identité, seule une inspection comportementale au niveau du pare-feu (fréquence des requêtes, empreinte réseau, cohérence des en-têtes) peut le détecter.
Cloudflare et le blocage par défaut des robots IA
Cloudflare a introduit un programme de blocage par défaut des robots IA sur les domaines hébergés derrière son réseau qui affichent aussi des signaux publicitaires — une politique à échéance du 15 septembre 2026. Cette mesure ne couvre toutefois que 8,5 % du top du web, puisqu’elle exige à la fois la présence derrière le proxy Cloudflare (26 % des sites) et la présence de signaux publicitaires. Cloudflare a aussi lancé un programme de paiement à la visite (« pay-per-crawl ») : un robot sans entente payante reçoit un code HTTP 402 (Paiement requis) plutôt qu’un blocage classique. Dans l’étude HasData, 10,9 % des réponses d’application mesurées contre GPTBot étaient des 402. Sources : Cloudflare, 2026 et Cloudflare, 2026.
Chaque fournisseur d’infrastructure applique une stratégie différente : Fastly bloque durement dans 61,5 % des cas, Cloudflare privilégie un test de vérification JavaScript dans 24,7 % des cas, Akamai combine limitation de débit et blocage, et Amazon CloudFront reste largement permissif (78,5 % des requêtes GPTBot passent sans intervention). Le CDN devant votre site détermine autant votre politique réelle que votre fichier robots.txt.
Ce qu’un blocage ne change pas
Bloquer GPTBot, ClaudeBot et PerplexityBot n’a aucun effet sur votre présence dans les AI Overviews ou le mode IA de Google : ce comportement est contrôlé par une directive séparée, Google-Extended, qui régit l’utilisation du contenu déjà présent dans l’index de recherche classique de Google. Un site peut bloquer tous les robots IA tiers et continuer d’apparaître dans les réponses génératives de Google, simplement parce que ce contenu était déjà indexé par ailleurs.
L’étude HasData illustre même un effet inverse à l’intuition : dans un échantillon de requêtes testées sur le mode IA de Google, 51,9 % des domaines cités bloquaient au moins un robot IA dans leur robots.txt, contre 15 % dans l’échantillon général — soit plus de trois fois le taux de référence. Bloquer un robot IA tiers n’exclut donc pas nécessairement un site des réponses génératives, tant que Google a déjà indexé le contenu par sa voie classique. C’est un rappel utile que le référencement pour les moteurs génératifs (GEO) et la gestion des robots IA sont deux leviers distincts, pas un seul.
Le fichier llms.txt souffre d’un problème similaire : c’est aussi un signal déclaratif, publié volontairement, qu’aucun grand modèle ne s’engage à respecter ni même à consulter en priorité. Le robots.txt et le llms.txt partagent le même angle mort — ils expriment une intention, sans garantie d’exécution du côté du robot.
Comment configurer votre robots.txt étape par étape
Décidez d’abord votre politique : bloquer l’entraînement mais autoriser la citation est le compromis le plus courant pour une PME qui veut rester visible dans les réponses génératives sans céder son contenu à l’entraînement gratuit d’un modèle.
Ajoutez ensuite les blocs User-agent correspondants dans le fichier robots.txt à la racine du domaine, comme illustré plus haut. WordPress ne gère pas nativement l’édition de ce fichier à la racine — un plugin dédié ou une règle de réécriture serveur est généralement nécessaire pour insérer du contenu personnalisé sans perdre les directives générées automatiquement par le CMS.
Si le blocage doit être réellement appliqué (pas seulement déclaré), configurez une règle au niveau du CDN ou du pare-feu applicatif qui filtre par en-tête User-Agent — c’est cette couche, pas le robots.txt, qui empêche physiquement l’accès. Pour les sites sur Cloudflare, les règles de pare-feu gérées incluent des groupes préconfigurés pour les principaux robots IA.
Vérifiez enfin l’authenticité des requêtes avant de bloquer une plage d’adresses IP entière : OpenAI publie ses plages IP officielles à `/gptbot.json`, et Perplexity aux adresses `perplexitybot.json` et `perplexity-user.json` sur son domaine. Une requête qui prétend être GPTBot depuis une adresse hors de cette plage est une usurpation, pas le robot lui-même — le même principe de vérification d’identité que celui décrit dans notre guide sur l’entity SEO, où la cohérence des signaux d’identité détermine si Google et les IA reconnaissent réellement votre entreprise.
Erreurs courantes
1. Bloquer tous les robots IA sans distinction
Confondre GPTBot (entraînement) et OAI-SearchBot ou ChatGPT-User (citation en temps réel) mène à bloquer par erreur les canaux qui pourraient générer des citations et du trafic qualifié.
2. Croire qu’une ligne dans le robots.txt suffit
Près de 40 % des blocages déclarés contre GPTBot ne sont pas appliqués dans les faits. Sans règle correspondante au niveau du serveur ou du CDN, le robots.txt reste une déclaration d’intention sans effet pratique.
3. Confondre le blocage des robots IA et la visibilité dans Google
Google-Extended est une directive distincte de GPTBot ou ClaudeBot. Bloquer les robots tiers ne retire pas un site des réponses génératives de Google si le contenu est déjà indexé classiquement.
4. Ignorer la différence entre robots IA et exécution CDN
Deux sites avec le même robots.txt peuvent obtenir des résultats d’application complètement différents selon qu’ils sont derrière Cloudflare, Fastly, Akamai ou aucun CDN — chacun applique une stratégie distincte.
5. Ne jamais revoir sa politique
Les robots IA évoluent rapidement : nouveaux user-agents, nouvelles ententes commerciales, nouveaux comportements de contournement. Une politique figée depuis 2024 est probablement déjà dépassée.
Ce que nous observons chez nos clients
La majorité des PME que nous accompagnons n’ont jamais examiné leur fichier robots.txt depuis sa création par défaut lors du lancement du site — souvent une configuration générique qui ne distingue même pas les robots IA les uns des autres. Le réflexe une fois sensibilisées est presque toujours de tout bloquer, alors qu’une approche sélective protège mieux les intérêts réels de l’entreprise : refuser l’entraînement gratuit tout en restant éligible aux citations.
Une fois la configuration ajustée, la meilleure façon de mesurer l’effet réel est d’auditer ce que ChatGPT et Perplexity disent déjà de votre entreprise — un blocage mal calibré se remarque souvent d’abord dans la disparition ou la dégradation de ces réponses.
Configurer vos robots IA correctement
L’audit technique du robots.txt, la configuration des règles de pare-feu applicatif et la stratégie de blocage sélectif font partie de nos mandats SEO/GEO pour les PME et OBNL québécois.
👉 Découvrir notre agence SEO à Montréal
Conclusion
Un robots.txt mal configuré donne un faux sentiment de contrôle : la ligne est là, mais rien ne l’applique. La vraie question n’est pas « ai-je bloqué GPTBot ? » mais « ce blocage est-il réellement exécuté au niveau de mon serveur ou de mon CDN, et ai-je fait la distinction entre entraînement et citation ? ». Une politique sélective, techniquement appliquée et révisée régulièrement, protège mieux une PME qu’un blocage général qui, dans quatre cas sur dix, n’est qu’une déclaration sans effet.
